如何在每个 AI 视频片段中保持角色一致
为什么 AI 视频中的角色会在不同镜头之间发生变化,以及保持角色一致的两件事:先绘制分镜,以及使用参考照片。同时提供关于面部、服装和年龄变化的实用技巧。
你生成了一个很棒的第一段视频。女主角有一头赤褐色头发、绿色眼睛,穿着一件带白色衣领的灰色连衣裙。接着你生成第二段视频,她却变成了另一个人。这是关于 AI 视频最常见的抱怨,而它有明确的原因,也有办法避免。
角色在片段之间发生变化的原因
视频模型没有记忆。每个片段都是独立生成的,只依据提示词中的文字和提供给它的图像。“一位留着赤褐色头发的年轻女性”可以描述数百万张不同的脸,因此每个片段都会选出不同的人。即使将同一个提示词运行两次,也会得到两个不同的人。
因此,一致性不可能来自模型的记忆。它必须来自你每次交给模型的内容:相同的图片和相同的文字。
方法 1:先把角色画出来,然后根据这幅画进行拍摄
制作故事时,智能体会先绘制故事板:将九个关键画面绘制在同一张图中。由于九个画面是同时绘制的,其中的人物形象彼此一致。然后生成每段视频时,都会将故事板中的画面作为参考图,因此模型每次都从同一张画出的脸开始,而不是重新编造一张脸。
这是《项链》一分钟改编版的女主角:同一张画纸上的三个分镜格,分别展现她在家里、舞会上,以及十年后的样子。
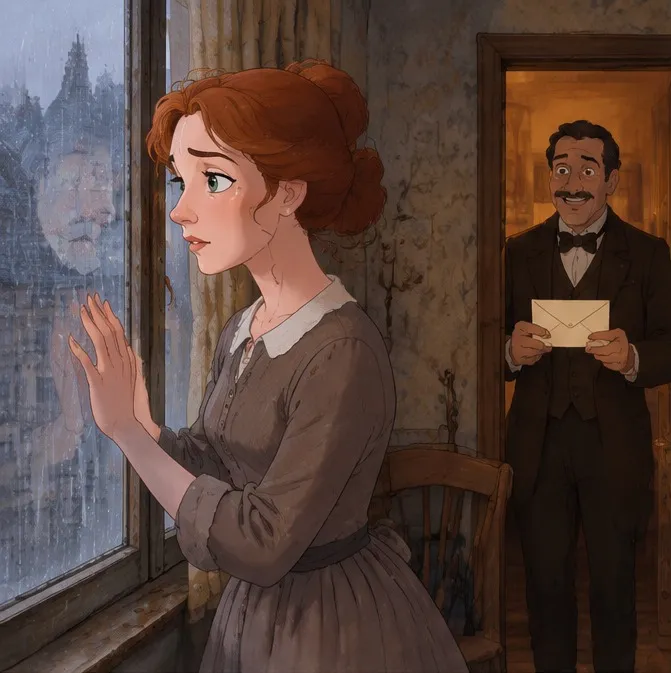
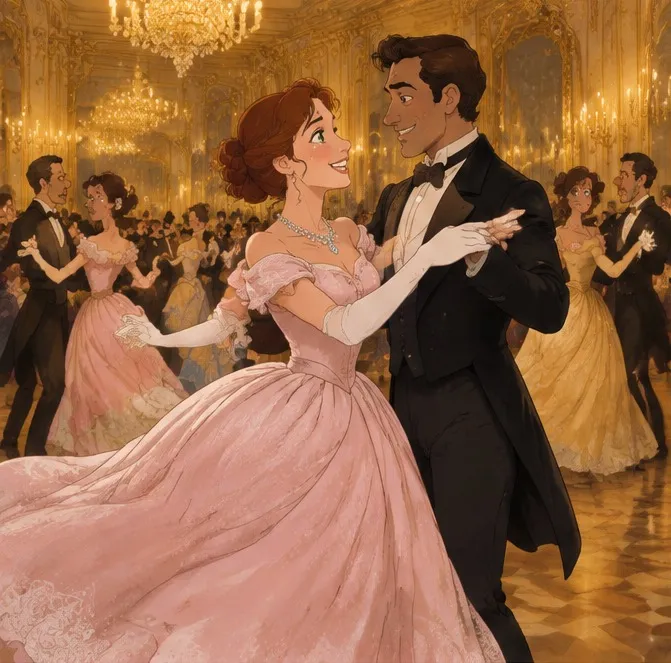
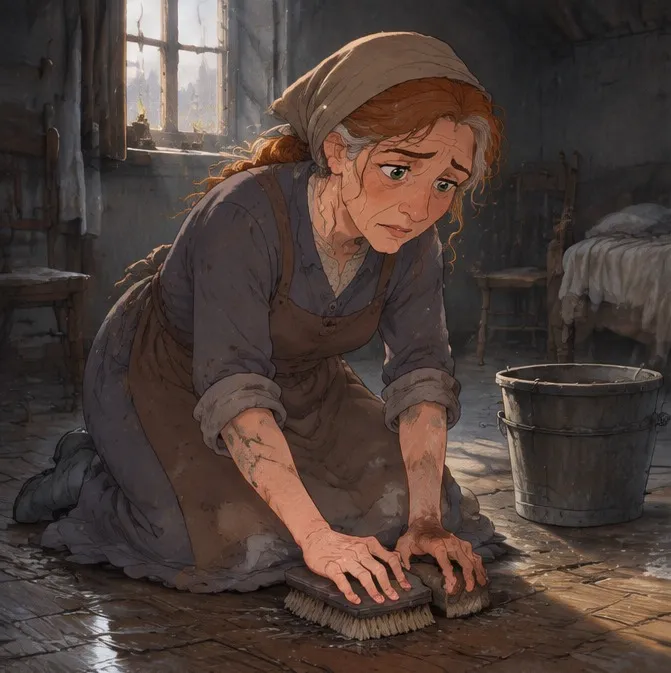
服装不同,光线不同,历经十年的艰辛,她依然一眼就能被认出来是同一个女人。这正是分镜发挥作用的体现。
修正2:每次都用相同的方式描述每个角色
图片呈现面容,文字则补充图片可能无法明确表达的一切。智能体会为每个角色编写一段固定描述,并在每个提示词中逐字重复,不会在一个片段里使用缩短版,又在下一个片段里换一种说法。好的角色描述包括:
- 年龄和体型:“一位大约25岁的苗条女性”。
- 两三个从远处也容易看清的特征:“松松挽起的赤褐色发髻、大大的绿色眼睛”。
- 具体的服装:“一条带白色衣领的褪色灰棕色棉质连衣裙”,而不是“朴素的连衣裙”。
当你自己撰写故事请求时,可以亲自提供这些细节。如果不提供,智能体会在计划中提出建议,你可以在开始绘制之前进行修改。
修正3:使用真实人物或事物的照片
如果这个角色已经存在(比如你自己、吉祥物、产品,或你之前视频中的角色),请附上它的图片。一个片段最多可以添加六张参考照片,并在提示词中逐一注明(“@Image 1中的女人”“@Image 2中的瓶子”),这样模型就能知道每张图片对应什么。片段会保留照片中的面容或物体原貌。
棘手情况的提示
更换服装
说明改变的内容以及发生的时间:“仅在舞会场景中,她穿着淡粉色露肩礼服,戴着长款白手套。”如果没有写明换装,看起来就像换了一个角色。
让角色变老
保持面部不变,只改变时间会带来的变化:“相同的脸和绿色眼睛,大约年长十岁,赤褐色头发中夹杂着灰白发丝,粗糙发红的双手。”重新撰写整段描述会生成另一个人。
两个长得相像的角色
给他们设置彼此鲜明对比的特征(黑发和红褐色头发、祖母绿和灰色),这样模型就不会把他们合并成一个人。智能体还会告诉模型,任意两个人物的外貌都不相同,而且同一个人物不会在一个画面中出现两次。
长篇故事
超过一张分镜表长度的故事会获得更多分镜表。每张新分镜表都会重复相同的文字角色描述,因此演员阵容会从一张分镜表延续到下一张。
批准片段前需要检查的内容
每个片段在生成前都会以卡片形式展示给你。请检查以下三点:
- 参考图是正确的面板或照片,且顺序正确。
- 提示词中的每个角色都与一张图片关联(“Mathilde @Image 1”)。
- 描述与计划中的描述一致,包括服装在内。
如果有任何不对,请按“Change something”并说明需要更改的内容。修改提示词比修改已经完成的片段便宜得多。